

나만의 로컬 AI 서버를 만들어보다
내 PC에 맞는 로컬 AI 모델 설치하기
▶ 클라우드 기반 AI 서비스와 다른 로컬 AI
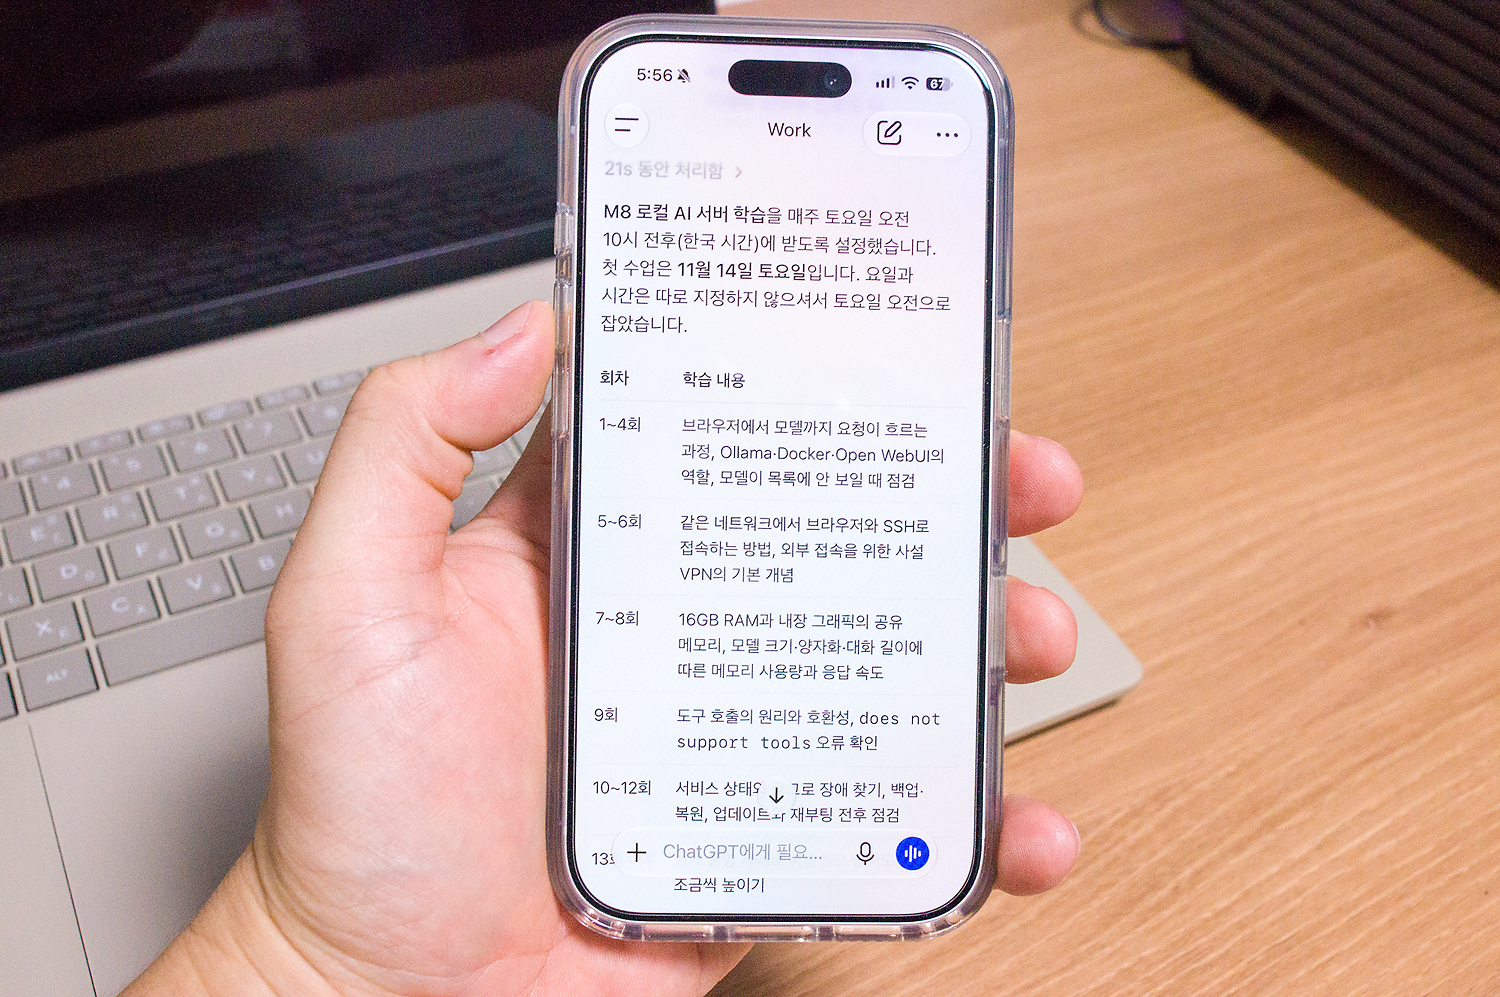
일상생활에서 사용하는 ChatGPT, 클로드, 제미나이와 같은 AI 서비스는 클라우드 기반 생성형 AI 서비스입니다. 사용자의 PC 또는 스마트 디바이스 사양과 상관없이 인터넷이 연결되는 장소라면 어디서든 동일한 서비스를 이용할 수 있습니다.
예를 들어 구독 중인 ChatGPT를 스마트폰에서 실행한 다음 새롭게 선보이는 ARM 기반 노트북에 대한 발표 자료를 만들어달라고 요청하면 다양한 사이트를 분석하여 사용자가 원하는 자료를 만들어줍니다.
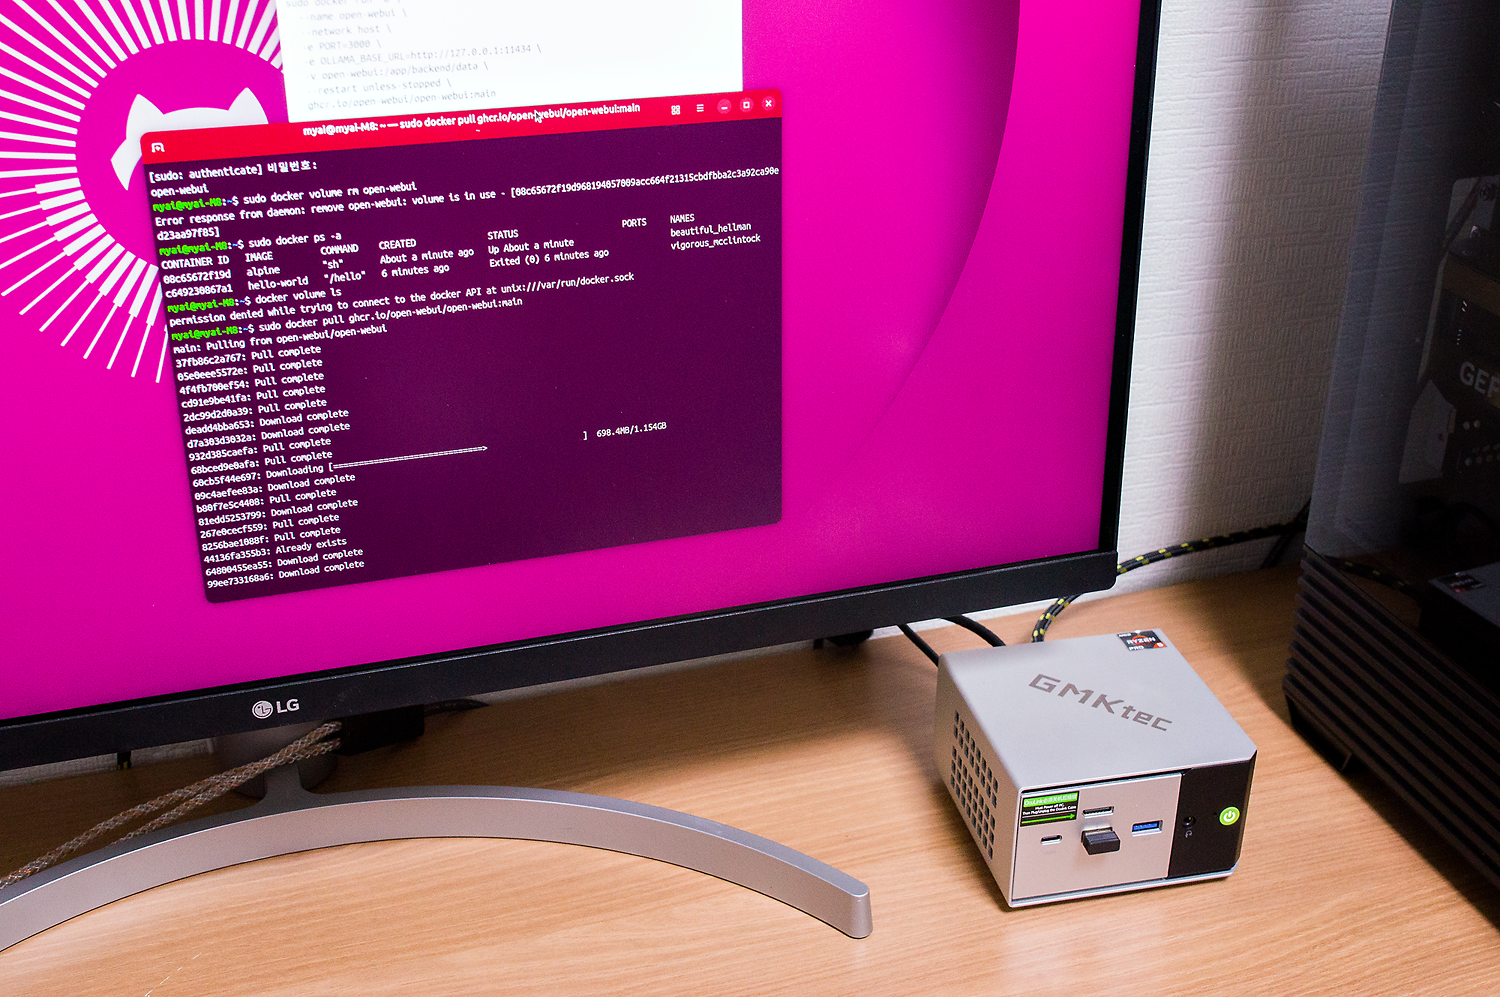
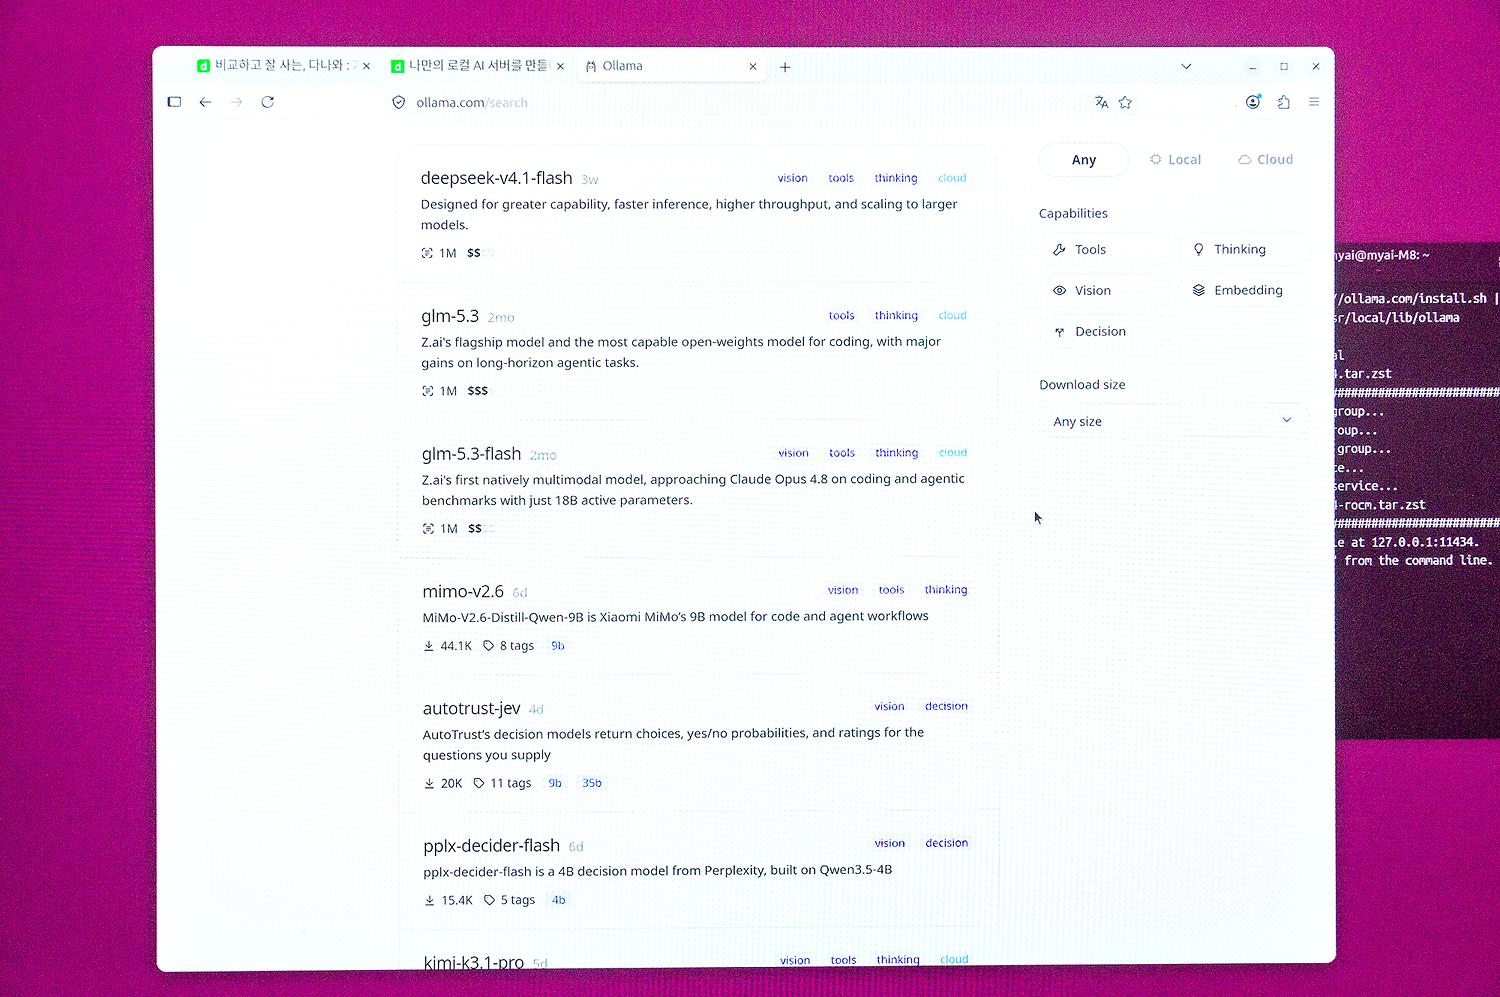
하지만 로컬 AI의 경우 클라우드 기반 AI 서비스와 다르게 나에게 맞는 로컬 AI 모델을 선택해야 합니다. PC에서 직접 설치하기 때문에 구동 관련하여 시스템에 적합한 모델을 선택해야 내가 원하는 결과를 빠르고 정확하게 도출할 수 있습니다.
만약, 내 PC 사양에 적합하지 않는 모델 또는 오버스펙의 모델을 설치한다면 원하는 결과물을 도출하는데 상당한 시간이 필요한 것 물론 내가 생각하고 있는 수준의 활용이 불가합니다.
▶내 PC사양에 맞는 AI 모델 크기 설정
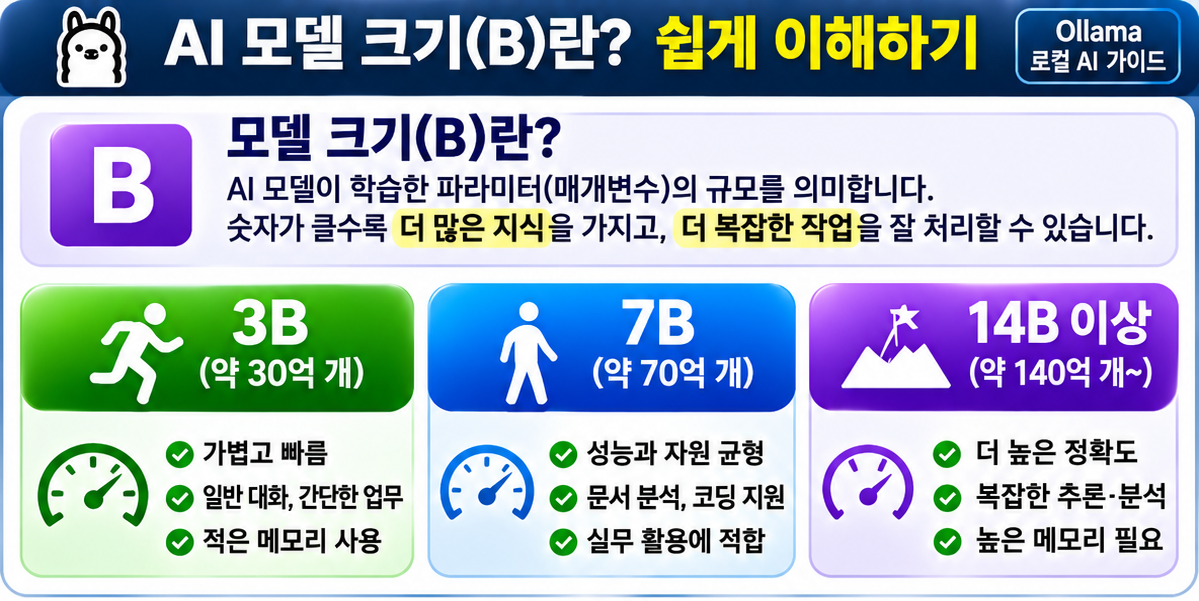
로컬 AI 서버를 구축한 다음 사용할 모델을 선택할 때 현재 사용 중인 사양을 고려하여 모델 크기를 선택해야 합니다. 모델 크기는 AI 모델이 학습한 파라미터의 규모를 의미하며 숫자가 클수록 더 많은 지식을 가지고 더 복잡한 작업을 처리할 수 있습니다.
단위는 B로 표시하며 최소 1B ~ 70B까지 다양하게 구성되어 있습니다. 예를 들어 3B의 경우 30억 개의 파라미터 규모이며 적은 메모리 사용으로 일반적인 대화, 간단한 업무가 가능합니다. 14B의 경우 140억 개 파라미터 규모이며 복잡한 추론 또는 분석에 적합한 모습을 보여줍니다.
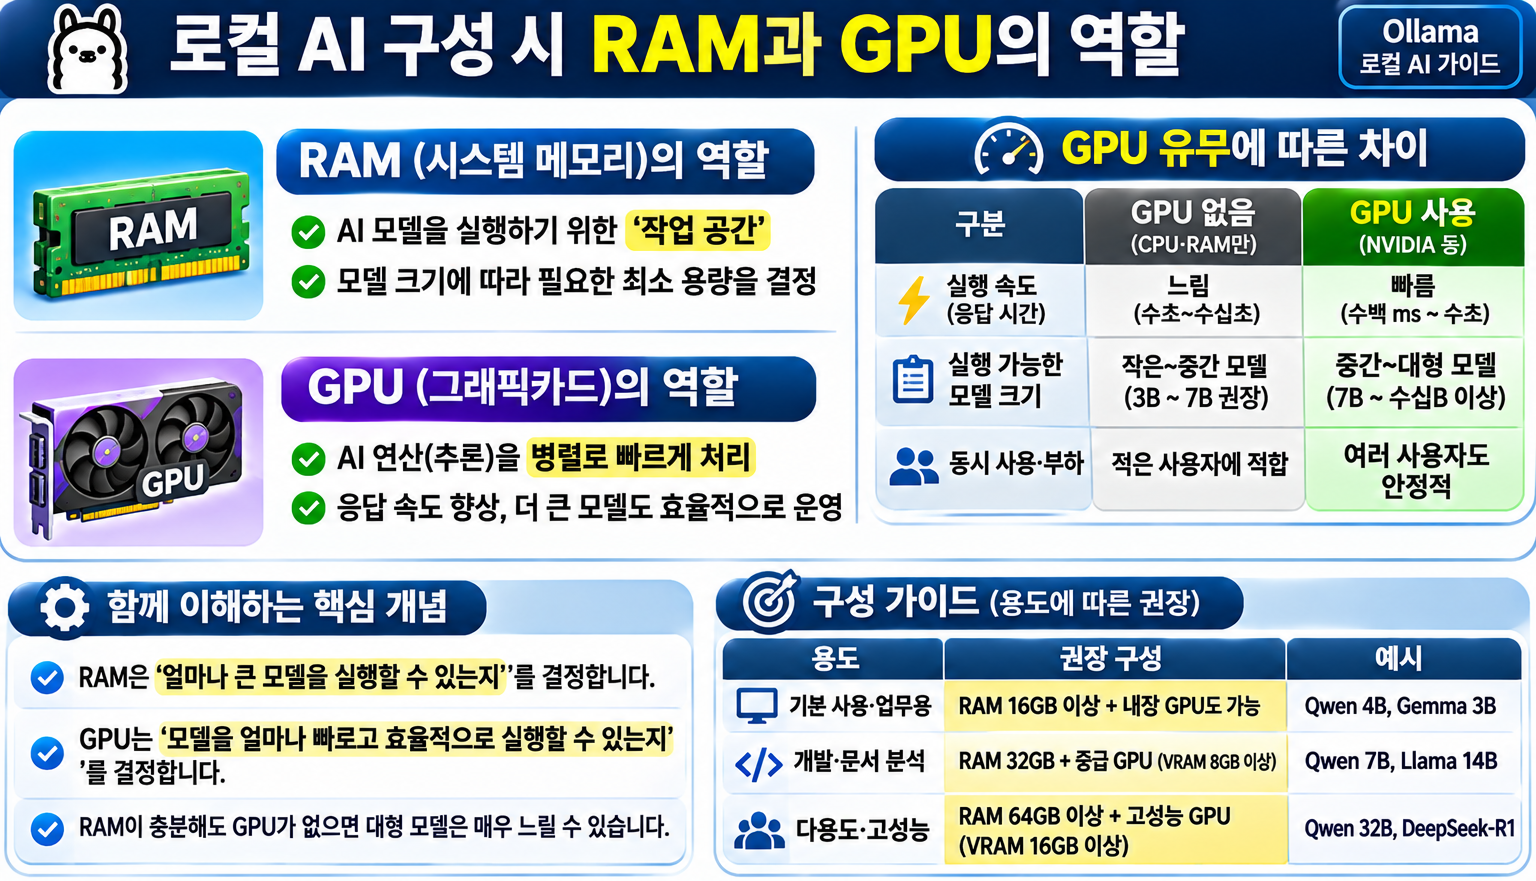
AI 모델 크기를 선택하는 데 있어 서버로 사용하는 시스템 사양을 꼼꼼하게 체크해야 합니다. RAM, GPU 사양에 따라 선택할 수 있는 모델 그리고 크기에 달라지기 때문입니다.
RAM과 GPU에 대한 역할을 살펴보면 RAM의 경우 AI 모델을 실행하기 위한 작업 공간이며 크기가 크면 클수록 사이즈가 큰 모델을 적용할 수 있습니다. GPU의 경우 AI 연산, 추론 시 병렬로 빠르게 처리할 수 있어 규모가 큰 모델을 빠르고 효율적으로 활용할 수 있도록 해줍니다.
▶내 PC에 맞는 로컬 AI 모델 선택하기
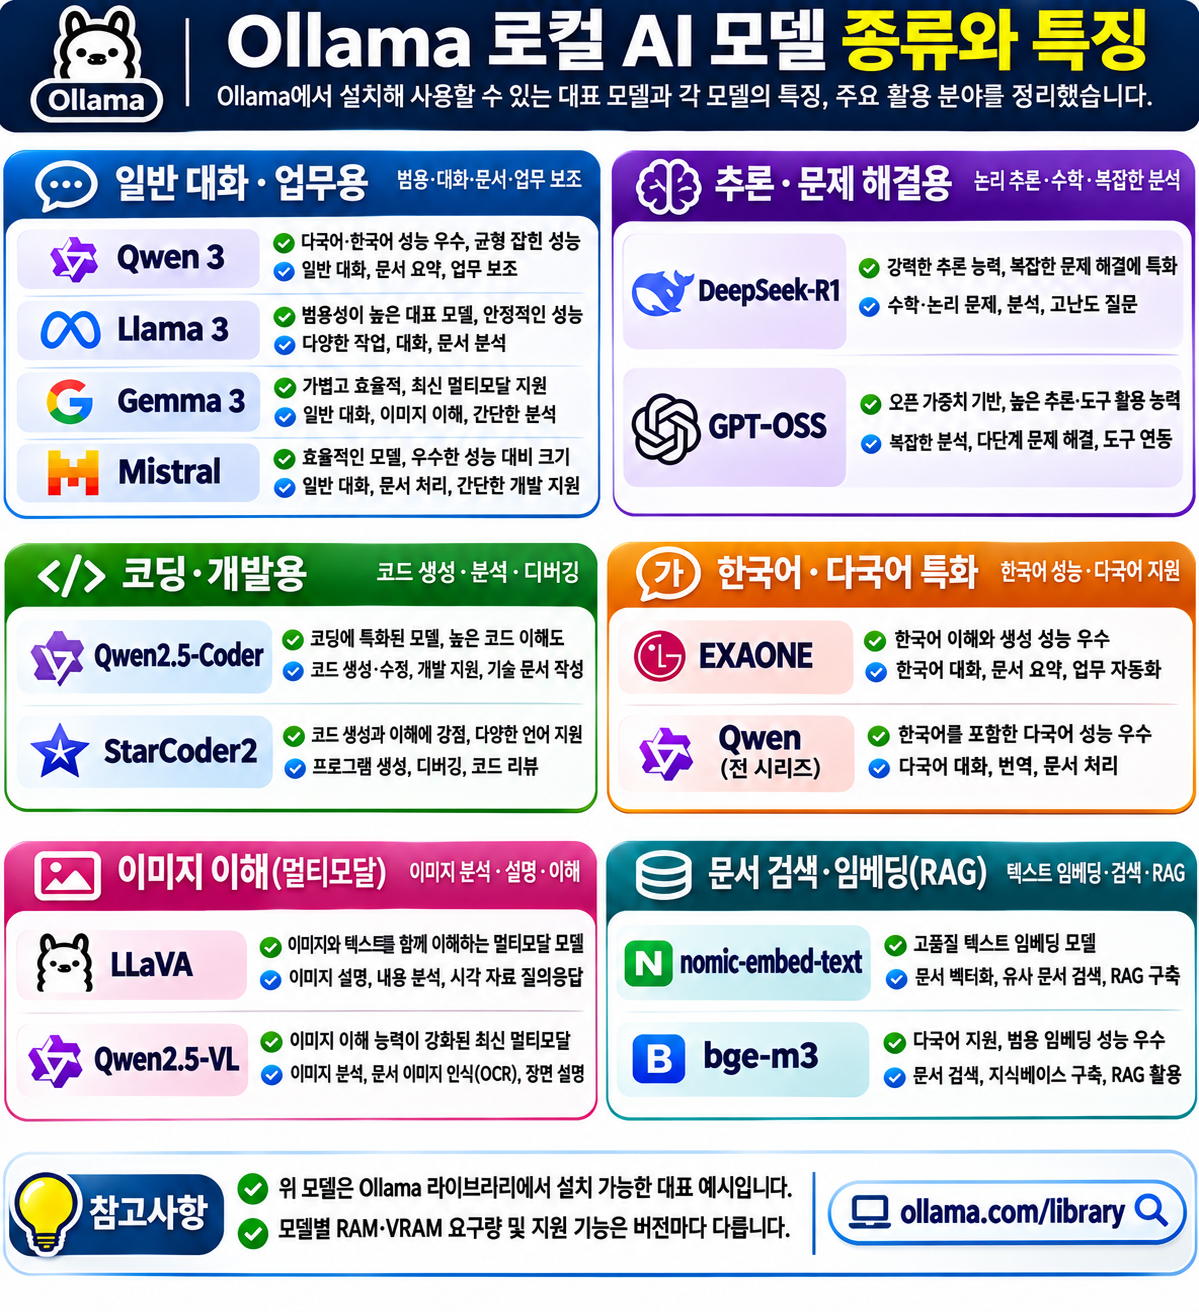
로컬 AI 모델을 살펴보면 우리가 생각지 못한 다양한 모델을 선보입니다. 각 모델별로 자신만의 특색을 지니고 있기 때문에 추구하는 방향에 맞는 모델을 선택하는 게 중요합니다.
위의 이미지는 AI 모델을 실행하는 엔진인 Ollama에서 설치 및 사용할 수 있는 모델을 정리한 이미지입니다. 앞서 말한 대로 각 모델별로 특성이 있어 나에게 맞는 모델을 선택하는 게 중요합니다.
예를 들어 일반 대화나 업무에 사용한 AI 비서를 원한다면 Qwen3, Gemma3와 같은 모델을 선택하면 됩니다. 반면, 추론이나 문제 해결에 집중한다면 DeepSeek R1, GPT-OSS와 같은 모델을 선택하면 됩니다.
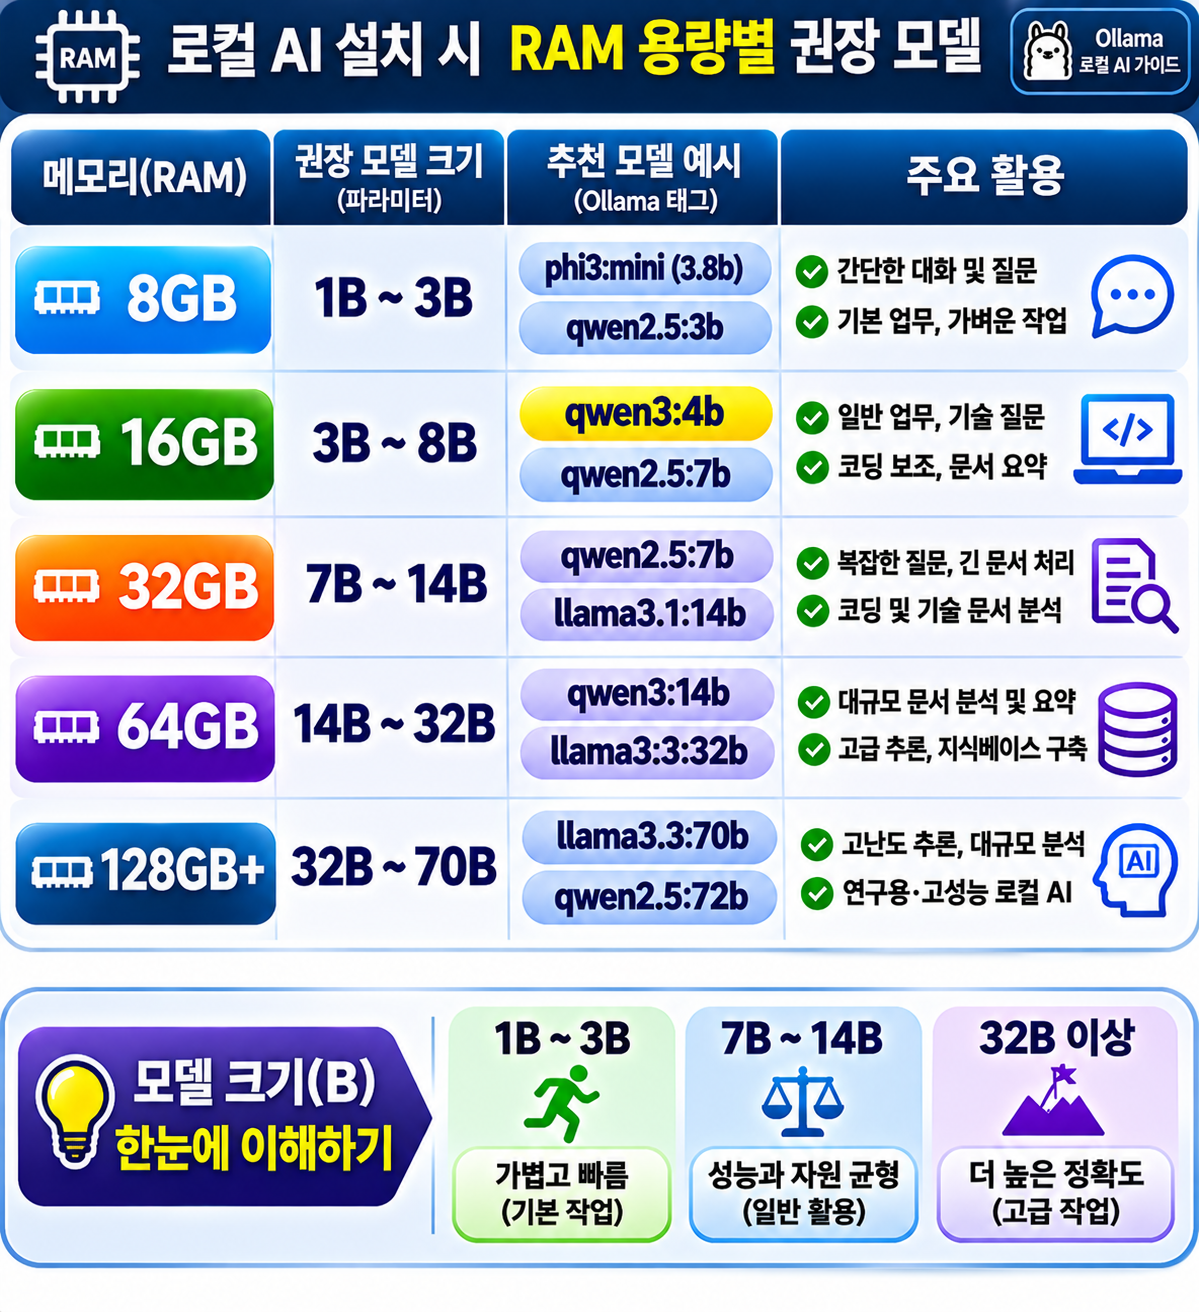
내가 사용할 모델을 선택했다면 내 PC 사양에 맞게 모델 크기를 선택하면 됩니다. RAM 용량에 따라 설치할 수 있는 크기가 결정되며 용량에 맞게 선택하는 게 베스트입니다.
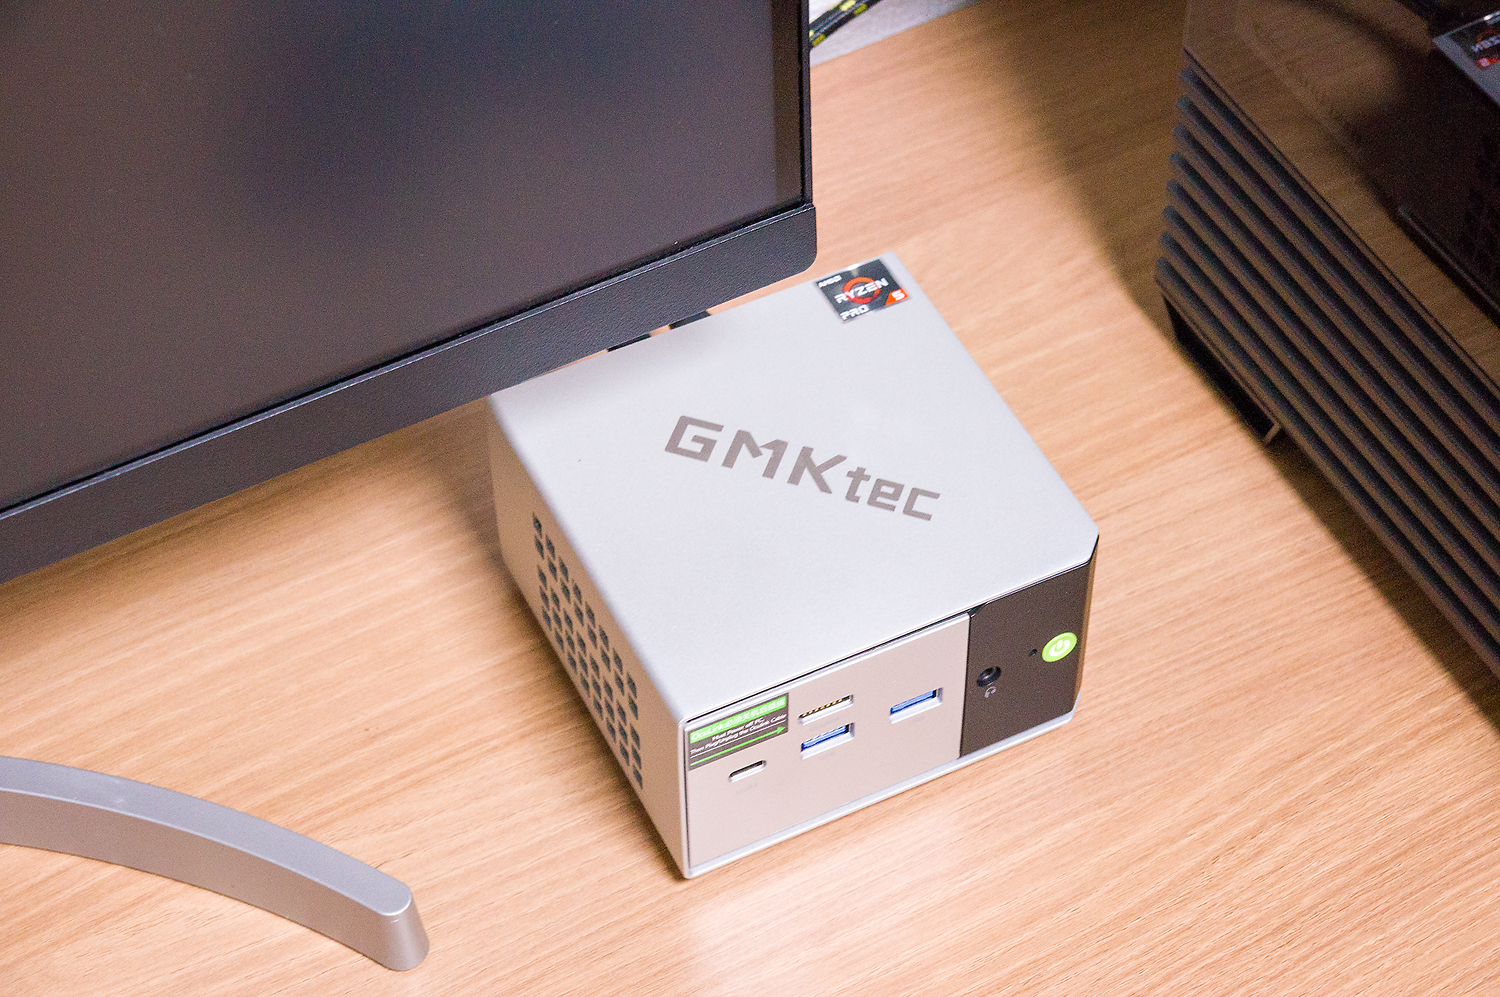
로컬 AI 서버 구축을 위해 구매한 미니 PC인 GMKtec M8의 LPDDR5 16GB RAM이 장착된 모델입니다. 온보드 타입이라 메모리 확장이 불가한 만큼 시스템에 맞는 크기를 선택한다면 3B ~8B 내외로 선택하는 게 베스트입니다.
▶ 내 PC에 로컬 AI 모델 설치하기
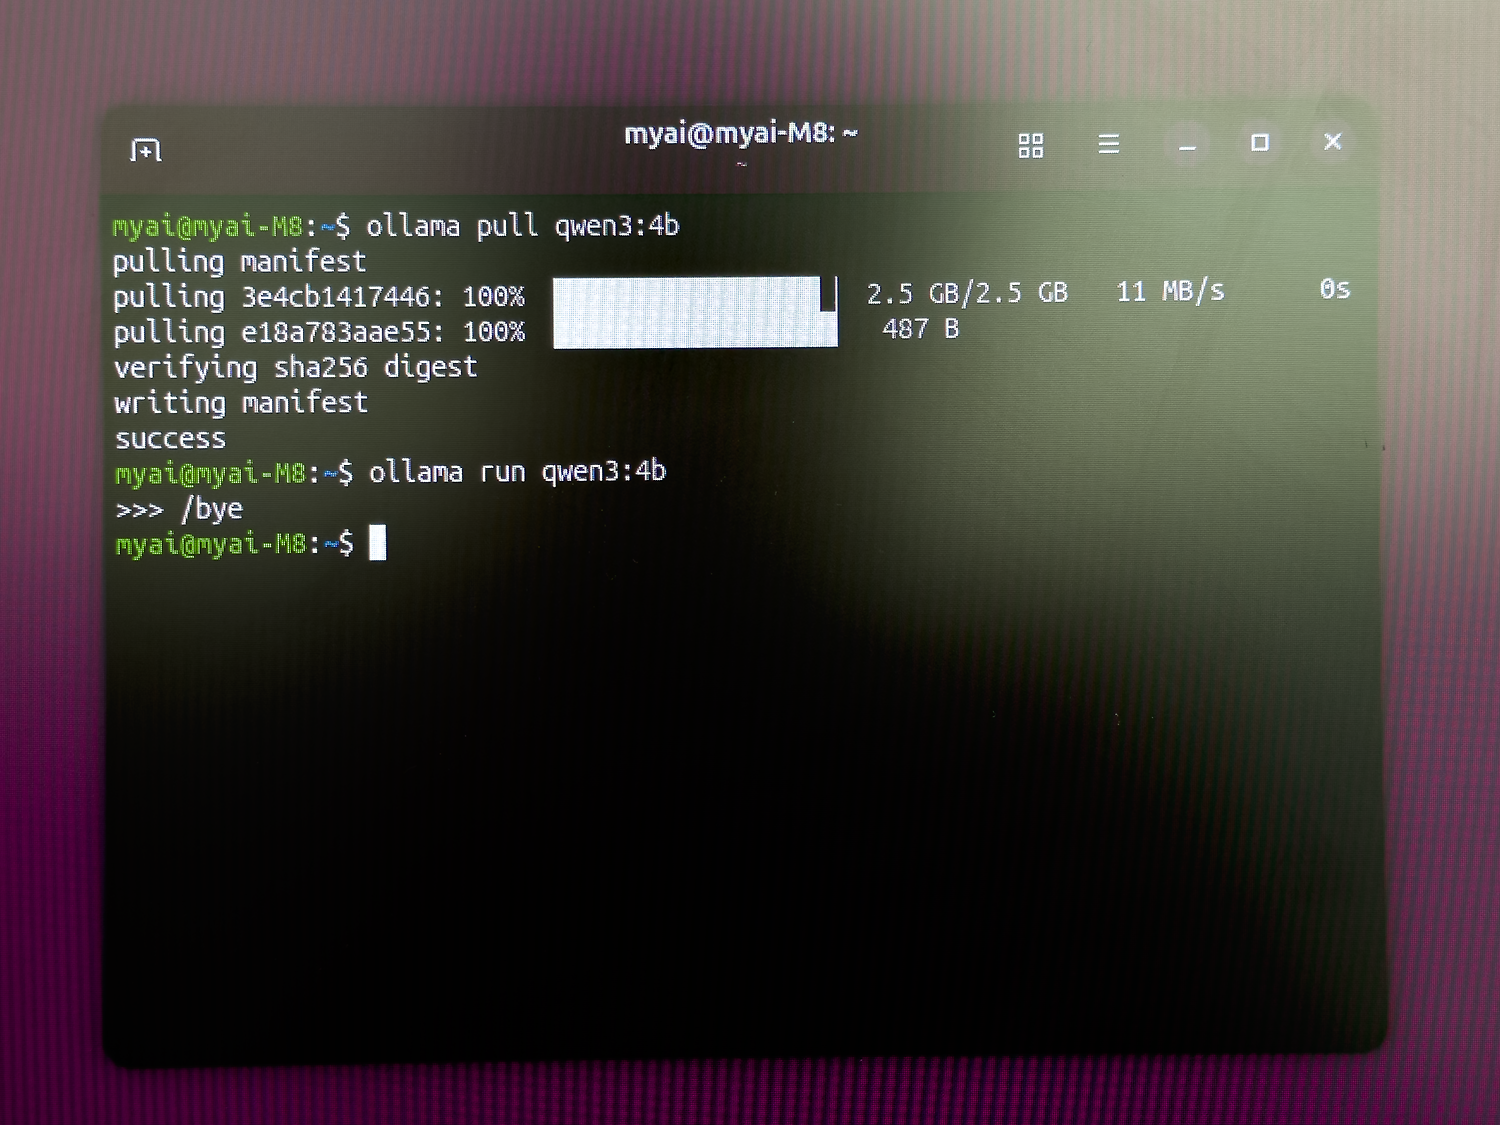
로컬 AI 구성 시 메인 OS로 윈도우가 아닌 리눅스인 우분투를 설치했습니다. 우분투에서 내가 원하는, 내 시스템에 맞는 AI 모델을 설치하려면 모델 + 모델 크기를 지정한 다음 명령어로 다운로드해야 합니다.
4B 크기인 Qwen3 모델을 받으려면 ollama pull qwen3:4b를 터미널 화면에서 입력하면 사이트에서 지정된 모델을 확인 후 다운로드합니다.
다운로드한 동작 시키려면 ollama run qwen3:4b라고 입력해야 동작됩니다. 리눅스에선 대부분의 과정이 명령어로 진행되기 때문에 입력 방법을 미리 체크하는 게 중요합니다.
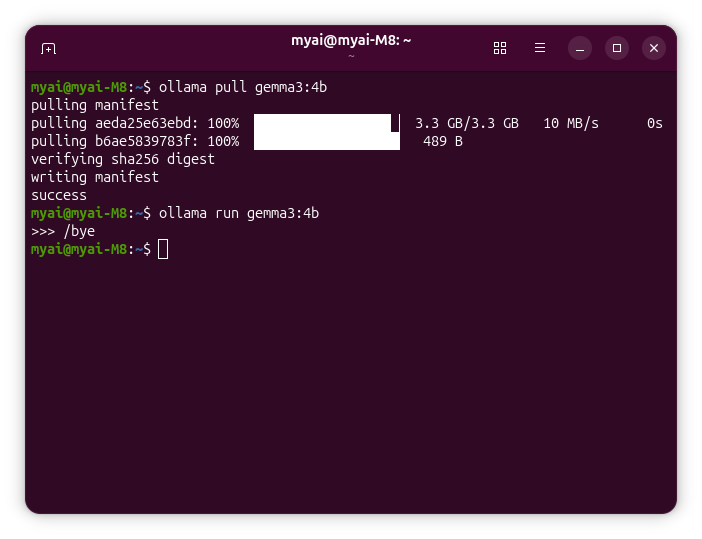
▲ gemma3:4b 모델 설치
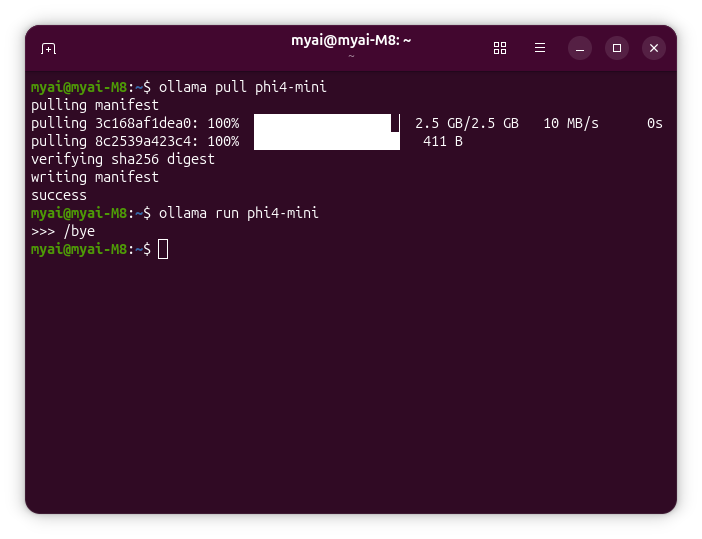
▲ phi4-mini 모델 설치
로컬 AI 서버로 사용 중인 GMKtec M8의 경우 RAM 용량이 16GB인만큼 모델 크기가 4B인 모델 위주로 설치했으며 다양한 모델을 선택하여 설치했습니다.
클라우드 기반인 ChatGPT, 클로드와 같은 서비스를 다양하게 이용하는 것과 동일하고 보면 됩니다. 제가 설치한 모델은 메인으로 사용할 Qwen3:4B를 비롯한 Gemma3:4B, PHI4-MINI입니다.
더 큰 사이즈로 설치 가능하지만 그에 따른 RAM 사용 비중이 커지는 만큼 빠른 데이터 처리가 불가합니다. 오히려 역효과가 발생할 수 있어 공간을 적절하게 사용하는 사이즈로 선택하는 게 좋습니다.
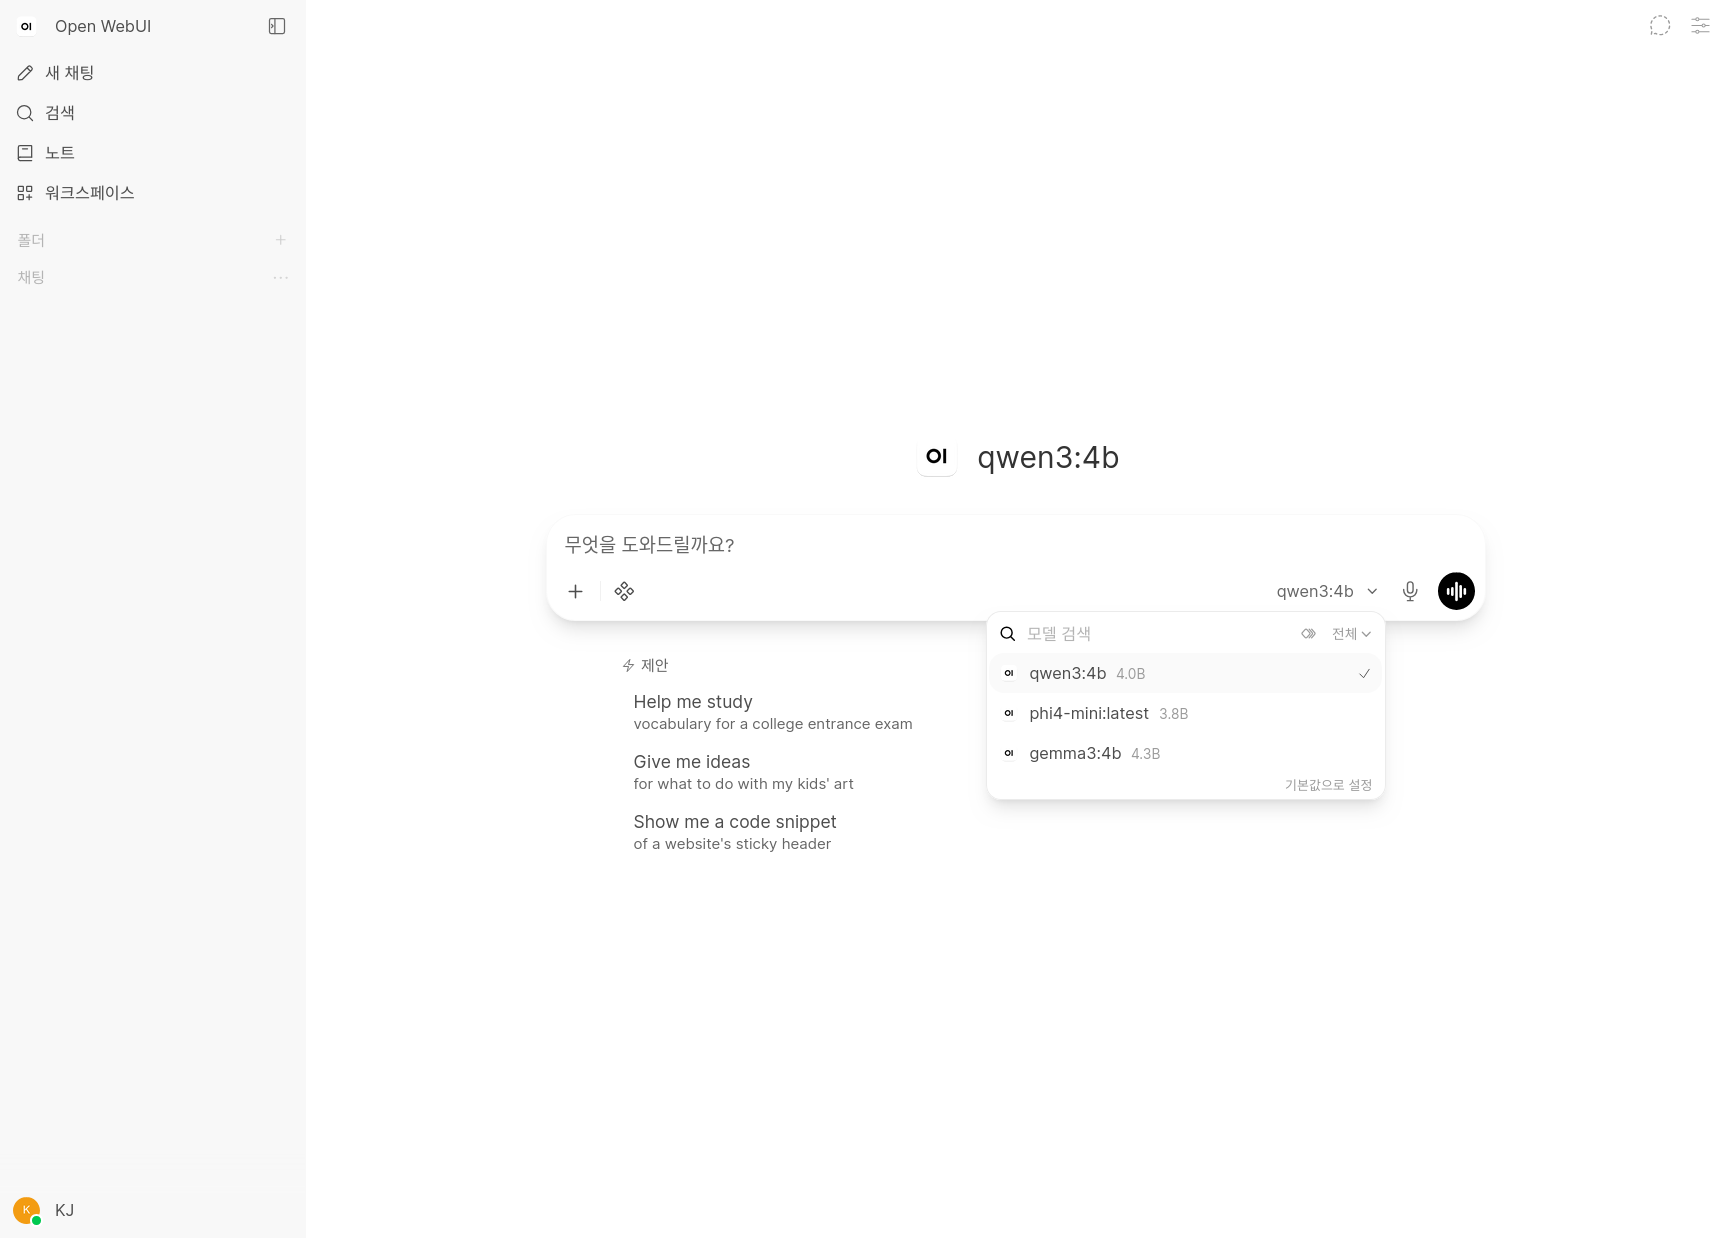
내가 원하는 모델을 설치한 다음 Open-WebUI에 접속해 보면 선택 가능한 모델에 설치된 모델 정보가 표시됩니다. 인터넷 서핑 시 검색 엔진을 선택하는 것과 동일하며 특색에 맞게 선택하면 됩니다.
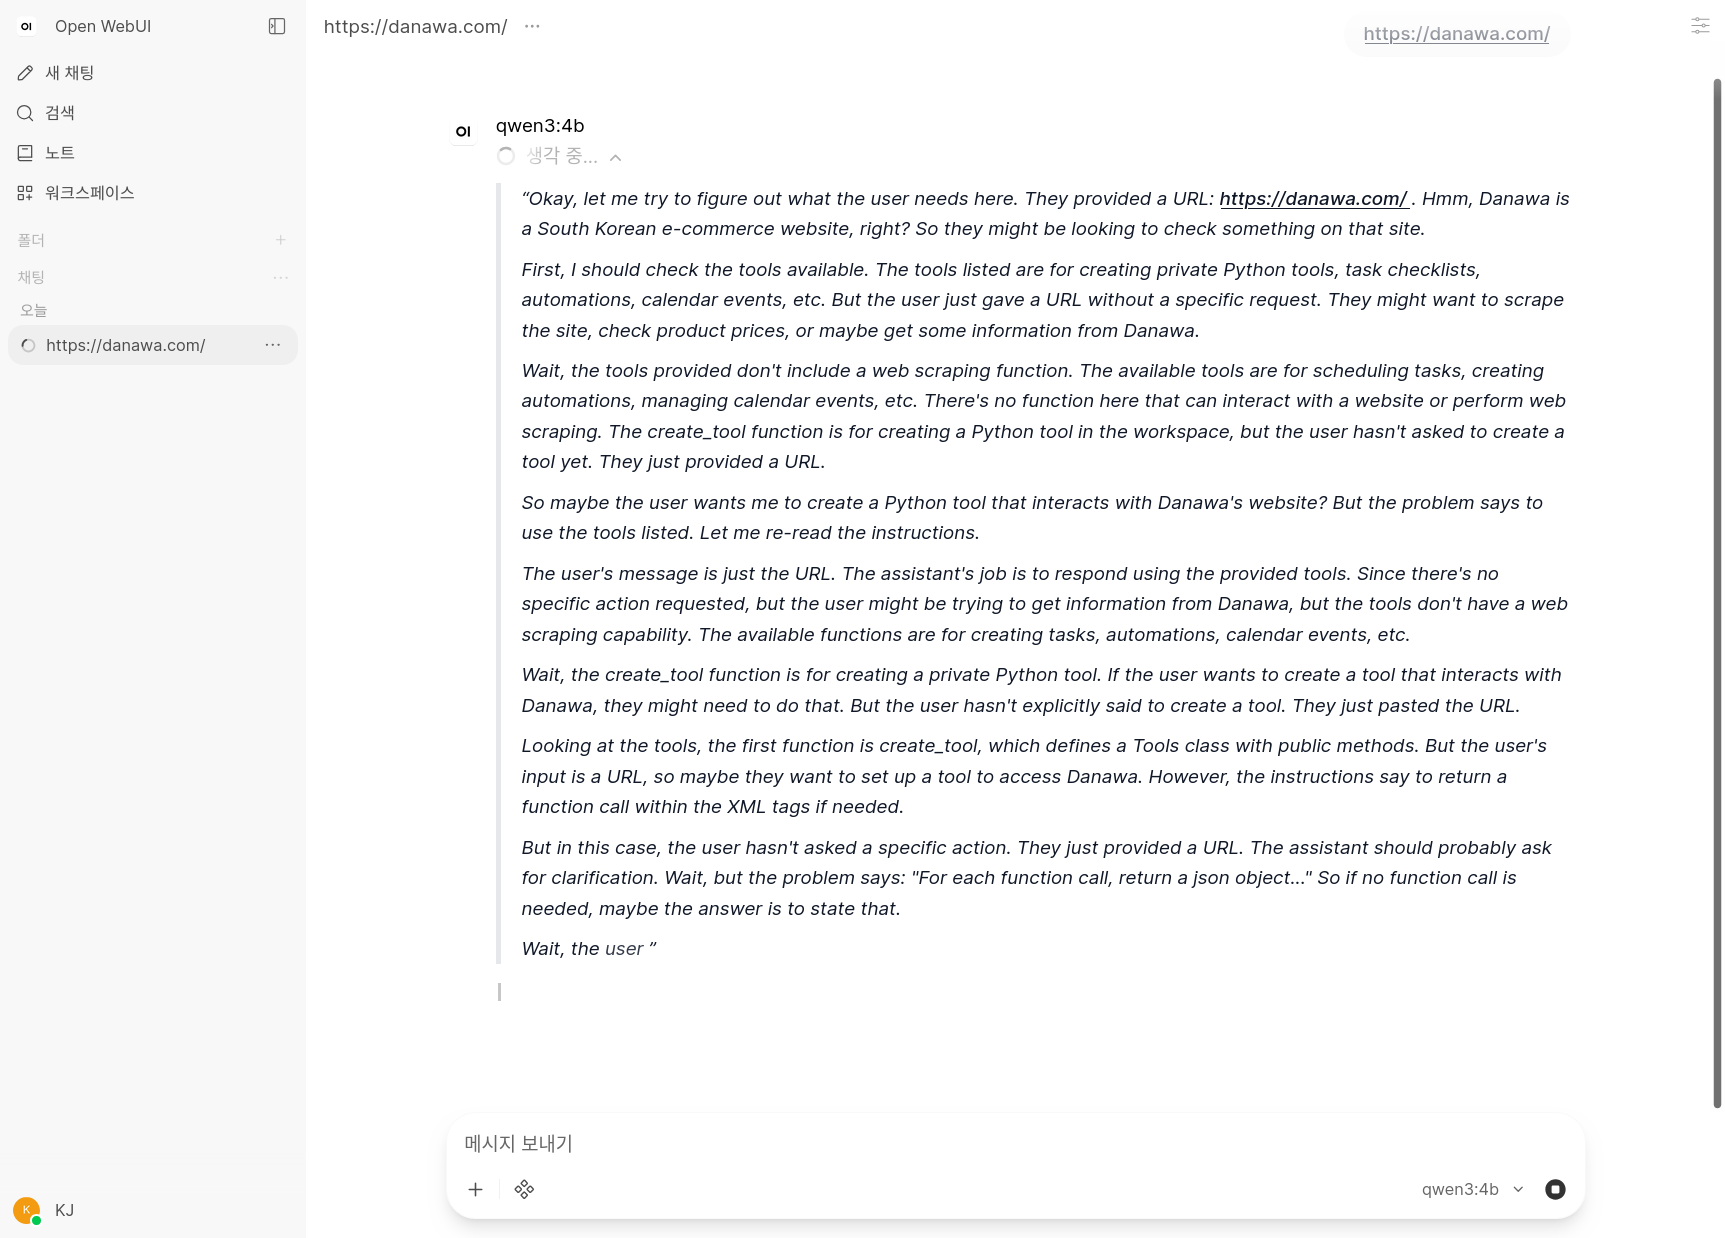
예를 들어 문서 요약부터 업무 보조에 특화된 Qwen3를 선택한 다음 웹 페이지에 대한 분석을 맡기면 페이지의 상세 정보가 표시됩니다.
▶ 내 PC에 맞는 로컬 AI 모델의 선택해야 하는 이유
클라우드 기반 AI 서비스와 다르게 로컬 AI의 경우 시스템 사양에 따라 활용할 수 있는 범위가 정해집니다. 사양이 좋으면 좋을수록 내가 원하는 모델을 더 큰 사이즈로 적용할 수 있습니다.
하지만, 사양에 올라감에 따라 비용도 급격하게 상승하기 때문에 선택과 집중이 필요합니다. 개인 서버용으로 사용할 제품의 경우 라이트 한 경우가 많다 보니 사이즈가 큰 모델보다는 RAM 용량에 맞는 모델을 선택하는 게 베스트입니다.
오늘 시간엔 로컬 AI 모델 설치 그리고 설치 시 꼭 확인해야 할 사항을 살펴봤다면 이어진 리뷰에서는 모델에 따른 차이, GUI 환경 구축 등을 소개하도록 하겠습니다.