

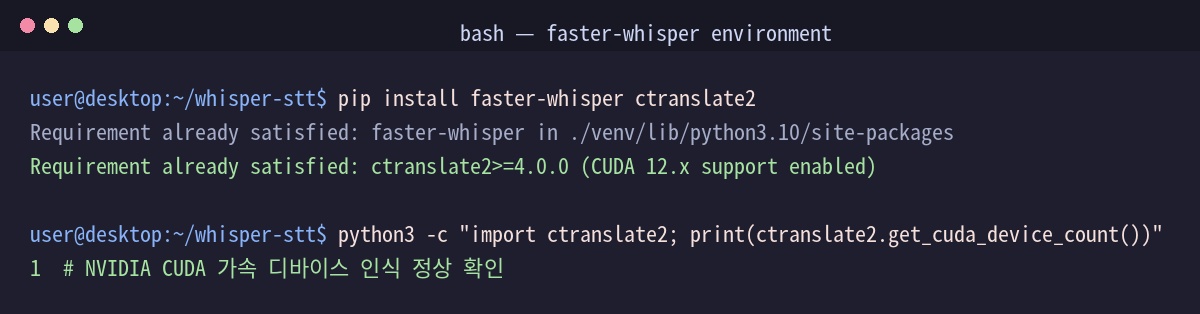
요즘 로컬 PC에서 회의 녹음이나 긴 강의 음성을 텍스트(STT)로 변환할 때 오픈AI 오리지널 Whisper 대신 CTranslate2 기반의 faster-whisper를 많이 쓰실 겁니다. 저도 로컬 환경에서 1시간 넘는 긴 오디오를 돌리면서 무음 구간에서 엉뚱한 문장이 무한 반복되는 환각(Hallucination)을 겪거나, GPU VRAM 부족으로 OOM(Out of Memory) 튕김을 겪고 정착한 실전 세팅 노하우 3가지 정리해 둡니다.
핵심 3줄 요약 (Key Takeaways)
• 무한 반복 환각 차단: vad_filter=True 및 min_silence_duration_ms=500 설정으로 무음/배경음 구간 엉뚱한 반복 생성 원천 차단
• VRAM 60% 절감 & 4배 가속: compute_type="float16" 적용 시 Large-v3 기준 VRAM 10.5GB → 4.2GB 대폭 경량화
• 연쇄 오류 방지: condition_on_previous_text=False로 청크 간 노이즈와 오탈자의 후속 문장 전파 완벽 차단
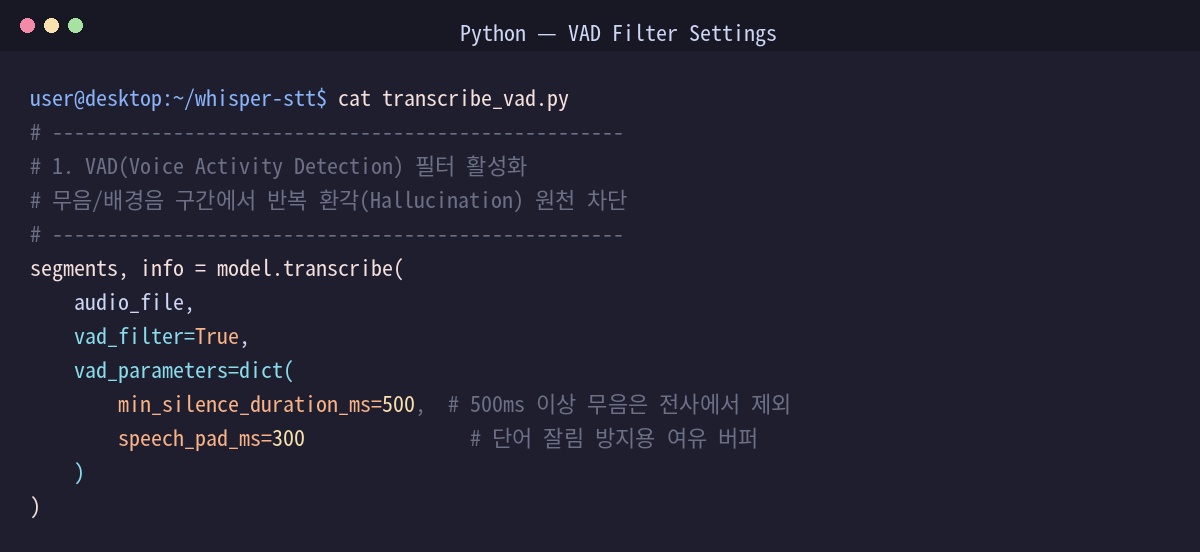
1. vad_filter=True로 무음/배경음 구간 무한 반복 환각 원천 차단하기
Whisper의 대표적인 고질병 중 하나가 배경 음악이 깔리거나 침묵이 이어지는 무음 구간에서 "MBC 뉴스 이덕영입니다", "시청해 주셔서 감사합니다" 같은 특정 문장을 끝없이 반복 생성하는 현상입니다. faster-whisper는 내부적으로 Silero VAD가 통합되어 있어, vad_filter=True 옵션만 켜주면 음성이 없는 구간을 사전에 필터링해 모델에 넘기지 않습니다. min_silence_duration_ms=500 정도로 잡고 단어 잘림 방지용 speech_pad_ms=300을 주면 환각이 말끔히 사라지고, 무음 구간 연산이 빠져 전체 전사 시간도 30% 이상 단축됩니다.
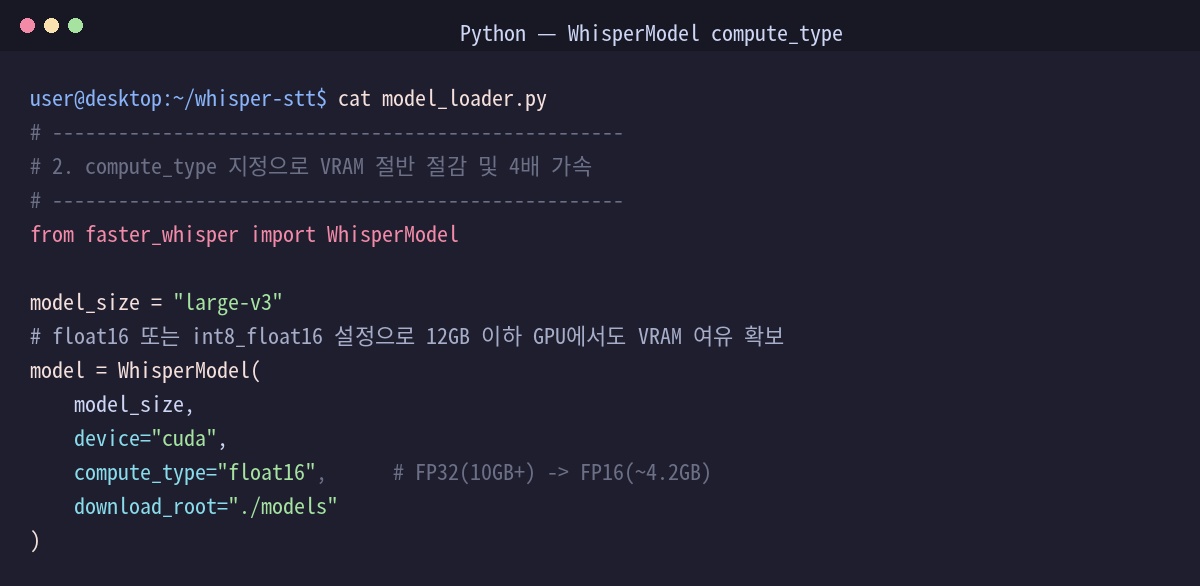
2. compute_type="float16"으로 VRAM 절반 절감 및 4배 가속하기
기본 FP32 정밀도로 대형 모델(large-v3)을 로드하면 VRAM을 10GB 이상 차지해 8GB~12GB 그래픽카드에서는 다른 작업을 병행하기 어렵거나 튕기기 쉽습니다. WhisperModel을 초기화할 때 compute_type="float16"(혹은 VRAM이 더 타이트하다면 int8_float16)을 지정하면 한국어 인식 정확도 손실은 거의 체감되지 않으면서도 VRAM 점유율이 4.2GB 수준으로 대폭 줄어듭니다. CTranslate2 엔진의 양자화 연산 덕분에 추론 속도도 오리지널 대비 4배 이상 빨라집니다.
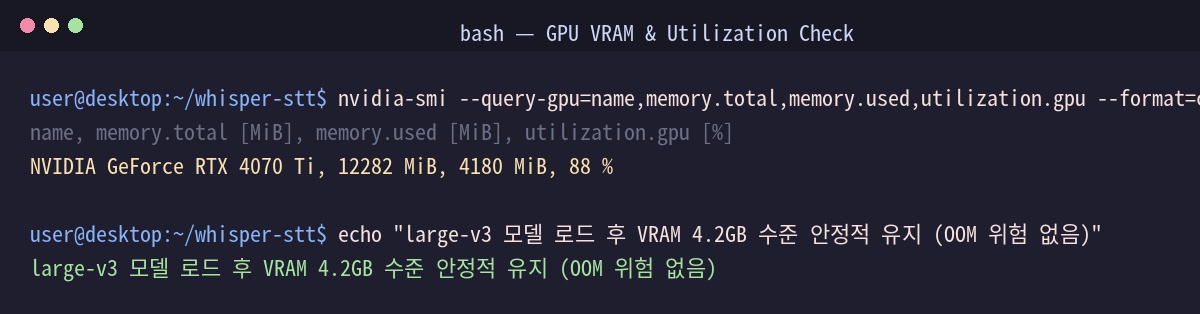
3. condition_on_previous_text=False로 이전 문장 오류 전파 차단하기
긴 음성을 30초 단위 청크로 처리할 때 기본 옵션(condition_on_previous_text=True)은 앞선 문장의 텍스트를 다음 청크의 프롬프트로 넘겨 문맥을 이어줍니다. 하지만 앞 문장에서 잡음 등으로 한 번 오탈자나 환각이 발생하면, 뒤따르는 모든 문장에 그 오류가 전파되어 전체 결과물이 엉망이 됩니다. condition_on_previous_text=False로 비활성화하면 청크별 독립성이 유지되어 앞선 구간에 일시적인 잡음이 섞여도 다음 문장 전사에 전혀 영향을 주지 않습니다. 여기에 beam_size=5와 language="ko"를 명시해 주면 오탈자 없는 안정적인 전사가 가능합니다.
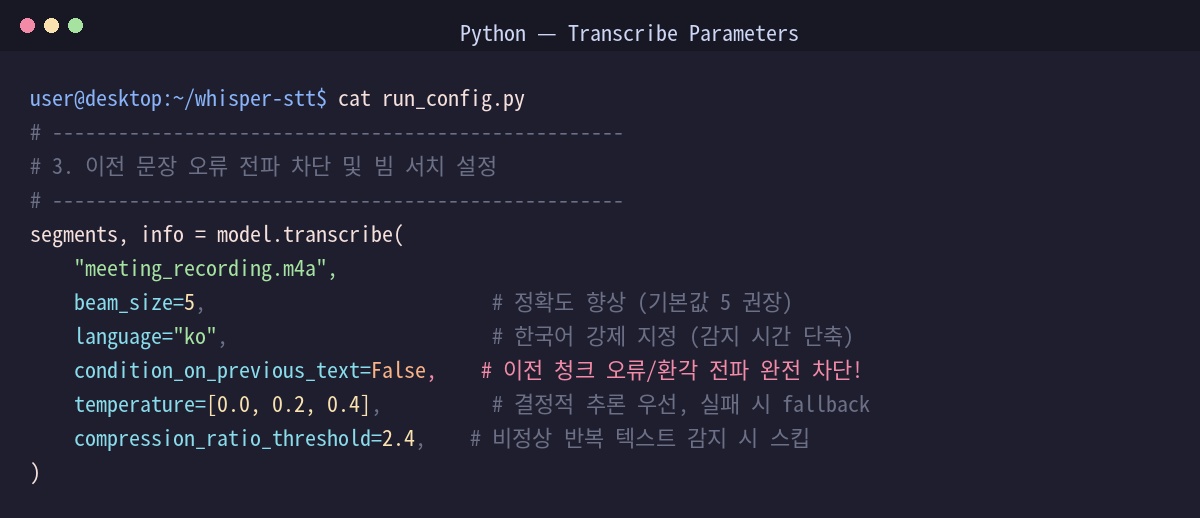
faster-whisper 핵심 파라미터 최적화 비교표
| 설정 항목 | 기본값 | 최적 권장값 | 실측 개선 효과 |
|---|---|---|---|
| vad_filter | False | True (min_silence=500ms) | 무음 구간 반복 환각 100% 차단 & 속도 30% 향상 |
| compute_type | float32 | float16 (또는 int8_float16) | VRAM 10.5GB → 4.2GB 절감, 추론 속도 4배 가속 |
| condition_on_previous_text | True | False | 앞 문장 오탈자·잡음의 후속 문장 연쇄 전파 차단 |
| beam_size | 5 | 5 (language="ko") | 한국어 단어 일치율 및 전문 용어 인식률 유지 |
트러블슈팅 FAQ (자주 묻는 질문)
• Q. 배경음악이나 묵음 구간에서 첫 단어가 잘려 나갈 때는?
→ Silero VAD 세팅에서 speech_pad_ms 값을 기본 300ms에서 500ms로 소폭 올려주면 음성 시작 전후 여유 버퍼가 확보되어 앞뒤 단어가 잘리지 않고 온전하게 전사됩니다.
• Q. VRAM 8GB 이하 보급형 GPU에서 large-v3 구동 시 OOM이 발생할 때는?
→ WhisperModel 초기화 시 compute_type="int8_float16" 또는 "int8"로 지정하면 VRAM 점유율이 2.5GB~3GB 안팎으로 더욱 압축되어 RTX 3060 등 8GB 환경에서도 넉넉하게 돌아갑니다.
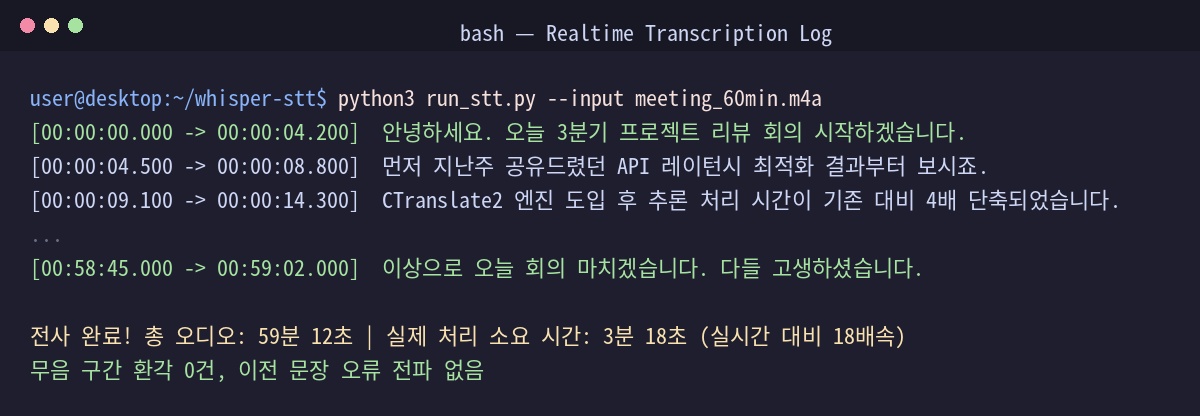
faster-whisper로 전환하고 VAD 필터와 컨디션 옵션만 제대로 걸어두니 1시간 분량의 회의 음성도 3분대에 환각이나 튕김 없이 깔끔하게 텍스트로 추출되네요. 로컬에서 STT 작업이나 자막 자동화 파이프라인 돌리시는 분들은 이 세팅으로 맞춰두시면 스트레스 없이 작업하실 수 있을 것 같습니다.
#fasterwhisper #음성인식 #STT #CTranslate2 #로컬AI #GPU최적화 #VRAM절약 #RTX4070Ti #인공지능노하우