

안녕하세요.
다나와 커뮤니티 막내운영자, 막운이입니다.
AI 영상 만들 때, 분명 같은 캐릭터인데 다음 컷에서 갑자기 다른 사람 목소리가 나온 적 있으신가요?
저도 말하는 비숑 영상을 만들면서 매번 ‘5살 여자아이 목소리’라고 적었는데요. 신나게 말해달라고 하거나 말하는 속도만 조금 바꿔도 다른 아이처럼 들리더라고요.
그래서 이번에는 캐릭터에 어울리는 목소리를 먼저 고르고, 그 목소리로 대사를 따로 만들어 입혀보면 어떨까? 싶었습니다.
오늘의 목차
- Pollo AI 한국어 TTS 5종 소개 : 어떤 TTS 모델들이 있을까?
- Pollo AI 한국어 TTS 5종 비교: 같은 대사를 넣으면 말투가 어떻게 달라질까?
- 내 목소리로 만든 AI 음성 비교: 오디오 참조와 음성 복제 중 어느 쪽이 원본과 더 비슷할까?
- 완성 영상 2종 비교: 영상과 음성을 한 번에 만들 때와 따로 더빙할 때, 어느 쪽이 컷마다 목소리를 잘 유지할까?
사용 툴 : Pollo AI 유료 (크레딧 필요함)
1. Pollo AI에서 목소리 모델 고르기
1) TTS란 무엇일까?
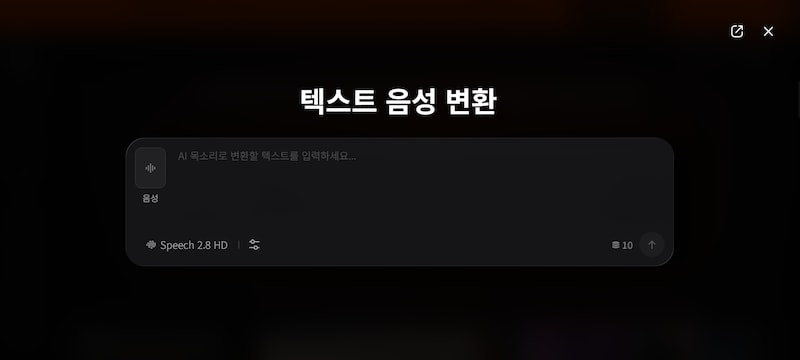
Pollo AI에 접속해 오디오 → 텍스트 음성 변환을 눌러줍니다. 여기에 대사를 입력하면 AI가 오디오 변환합니다. 이 기능을 TTS라고 합니다.
TTS는 Text-to-Speech(텍스트 음성 변환)의 줄임말로, 입력한 글을 AI가 목소리로 읽어주는 기능입니다. 직접 녹음하지 않아도 대사만 입력하면 영상에 넣을 내레이션이나 캐릭터 목소리를 만들 수 있어요. 흔히 릴스나 쇼츠에서 보셨던 "저 됐어요!! 뭐 됐어요!!" 하는 그 음성도 TTS입니다.
2) Pollo AI TTS 모델 5종 소개
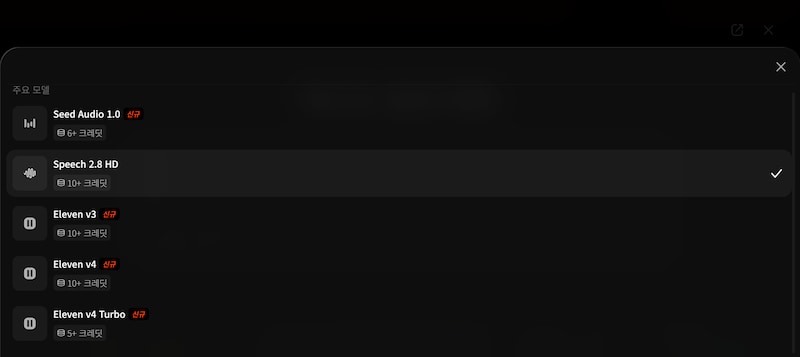
Pollo AI에 있는 TTS 모델은 총 5종입니다. Seed Audio 1.0, Speech 2.8 HD, Eleven v3, Eleven v4, Eleven v4 Turbo까지!
모델을 바꾸면 설정할 수 있는 항목도 조금씩 달라요.
Seed Audio 1.0은 음성 템플릿을 고르지 않아도 목소리를 만들어주고, @로 감정이나 말하는 타이밍도 지정할 수 있습니다. Speech 2.8 HD는 먼저 음성 템플릿을 골라줘야 해요.
Eleven v3는 원하는 대사를 입력해 생성해봤고요. Eleven v4와 v4 Turbo에서는 감정 표현에 영향을 주는 ‘안정성’과 선택한 목소리를 얼마나 닮게 할지 정하는 ‘유사도’도 조절할 수 있었습니다.
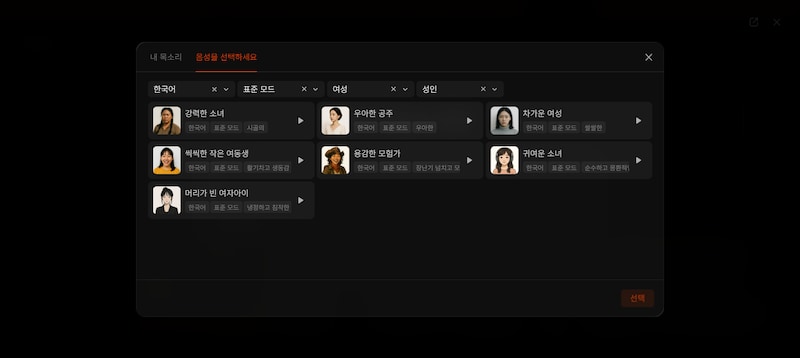
음성 버튼을 누르면 샘플 목소리를 선택할 수 있습니다. 언어, 억양, 성별, 나이를 선택 후 원하는 목소리를 고릅니다. 그 목소리대로 내가 작성한 텍스트가 음성으로 변환됩니다.
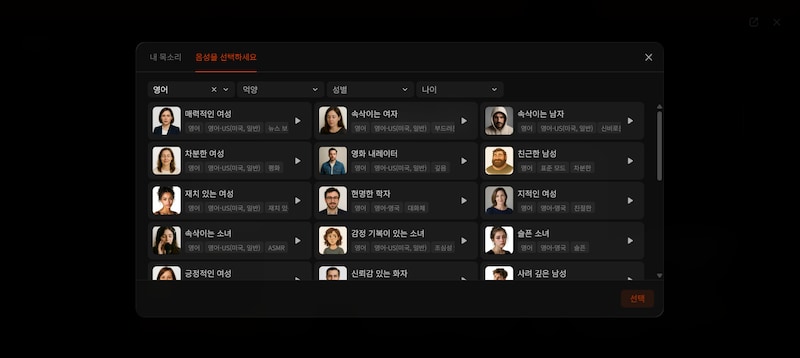
저는 이번 말하는 비숑 영상에 쓸 한국어, 표준어, 여성, 성인 보호자 '용감한 모험가'를 선택했습니다. 모델마다 같은 대사를 어떻게 읽는지 비교하기 위해 감정이나 속도에 대한 없이 대사 한 줄만 입력해볼게요!
2. 같은 대사를 5개 모델에 넣어봤습니다
1) 모델 5종 직접 들어봅시다
비숑이 산책의 '산'만 말해도 산책가자고 하더니, 목욕가야 한다고 하니 못 알아듣는 척을 합니다.
그래서 보호자가 이렇게 말합니다. "아까는 ‘산’만 말해도 알아듣더니?"
이 대사를 모델 5종에 넣어봤어요. 직접 들어보시고 여러분들의 의견도 댓글에 달아주세요!

여긴 제 개인적인 의견입니다.
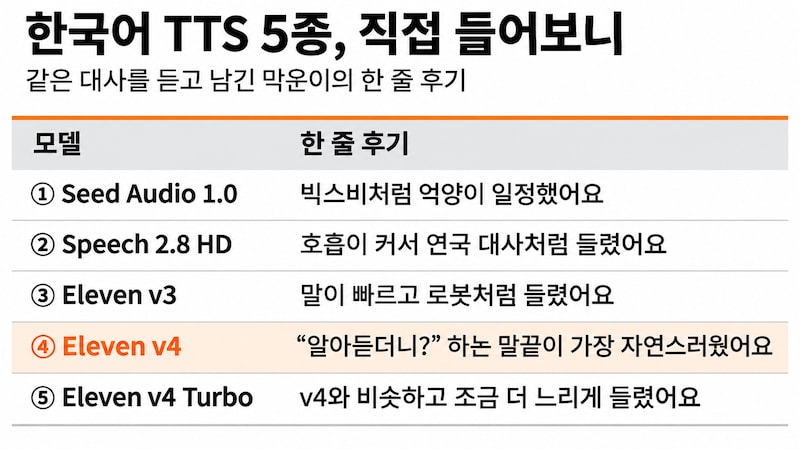
Seed Audio 1.0은 듣자마자 ‘어… 빅스비?’ 싶었습니다. 처음부터 끝까지 억양이 일정해서 비숑한테 장난스럽게 말하는 장면에는 조금 어색했어요.
Speech 2.8 HD는 거의 연극배우 같았어요. 대사 중간에 숨을 크게 한 번 쉬는데, 그 호흡에서 감정이 확 느껴지더라고요. Eleven v3는 말이 빨라서 대사가 훅 지나갔고, 제 귀에는 거의 로봇처럼 들렸습니다.
이번 장면에 제가 고른 건 Eleven v4예요. 특히 마지막 “알아듣더니?”를 한번 들어보세요. 비숑이 목욕 얘기만 못 들은 척하는 걸 엄마가 눈치채고 슬쩍 놀리는 느낌이 딱 나더라고요.
Eleven v4 Turbo도 v4보다 말이 살짝 느리게 들렸지만 말투는 비슷해서 괜찮았어요!
그럼 같은 대사 한 줄을 만드는 데 크레딧은 얼마나 들까요?
2) 모델 5종 크레딧은 얼마나 들까요?
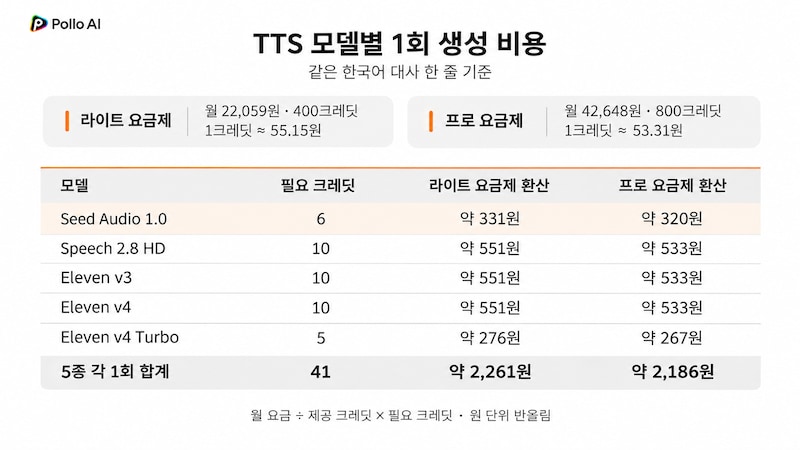
제가 테스트한 대사를 기준으로, 모델별 1회 생성 비용을 라이트와 프로 요금제로 나눠봤습니다.
가장 재미있었던 건 Eleven v4와 v4 Turbo의 차이였어요. 제 귀에는 두 모델의 말투가 꽤 비슷했는데, v4는 한 번에 10크레딧, Turbo는 5크레딧이 들었습니다. 프로 요금제로 환산하면 대사 한 줄에 각각 약 533원, 약 267원이에요.
저는 이번 장면에서는 “알아듣더니?” 하는 말끝이 자연스러운 v4가 더 마음에 들었어요. 여러 대사를 미리 들어볼 때는 비용이 절반인 Turbo부터 써볼 것 같아요.
이렇게 다섯 모델을 한 번씩 비교하는 데 든 크레딧은 총 41크레딧입니다. 라이트 기준 약 2,261원, 프로 기준 약 2,186원이에요.
그럼 이번에는 제가 직접 녹음한 목소리를 넣어볼게요. 과연 평소 제 말투까지 비슷하게 나올까요?
3. 이번엔 제 목소리를 넣어봤습니다
이번에는 제가 직접 녹음한 목소리를 복제하여 오디오 참조 1개와 음성 복제 2개, 제 목소리까지 총 4가지를 비교했습니다.
오디오 참조에서는 Seed Audio 1.0만 선택할 수 있었고, 1회에 6크레딧이 들었어요. @를 입력하면 이미 등록한 음성을 선택할 수 있고, 원하는 감정이나 말투도 적을 수 있습니다. 저는 제 목소리를 넣고 “비염 느낌을 10%로만 줄여줘”*라고 요청해봤어요.
음성 복제에서 실제로 사용할 수 있었던 모델은 Seed Audio 1.0과 Eleven v4 두 가지였습니다. Eleven v4는 30초 이상 녹음한 음성을 올려야 하고, 처음 ‘클린 보이스’로 등록할 때 100크레딧이 들어요. 등록한 목소리를 다시 사용할 때는 이 등록 비용이 또 들지는 않습니다.
자, 그럼 어떤 게 제 목소리와 제일 비슷한지 들어보세요!

제 귀에는 의외로 오디오 참조가 제일 비슷했어요. 아래 퍼센트는 제가 원본이랑 번갈아 들으면서 느낀 정도입니다.
- Seed 음성 복제 · 약 70% - 목소리는 꽤 비슷한데 말투가 조금 딱딱했어요. 특히 ‘가짜’를 ‘가자’라고 발음하더라고요. 그 부분 한번 들어보세요.
- Eleven v4 음성 복제 · 약 50% - 제가 컨디션 좋은 날, 아나운서한테 발음까지 배우고 면접을 봤다면 이런 목소리였을까요…? 발음은 또렷한데 평소의 저랑은 분위기가 좀 달랐습니다...!
- Seed 오디오 참조 · 약 90% - 평소 제 말투와 콧소리가 가장 익숙하게 들렸어요. 제가 듣기에도 ‘어, 이건 난데?’ 싶었습니다.
4. 완성 영상 비교
1) Pollo AI - GPT 연결해 시댄스로 영상+목소리 한 번에 만들기
첫 번째 영상은 Pollo AI의 이미지→비디오에서 시댄스 2.0으로 만들었습니다. 이번 설정은 컷당 60크레딧, 총 6컷으로 360크레딧이 들었어요. 한 컷에 라이트 요금제 기준 약 3,309원, 프로 요금제 기준 약 3,199원이에요. 월 요금을 기준으로 환산하면 라이트는 약 19,853원, 프로는 약 19,192원입니다.
대사까지 한 번에 만들어져서 편했습니다. 다만 6컷을 붙여서 들어보니, 같은 보호자가 말하는데도 장면이 바뀔 때마다 목소리가 조금씩 달라지는 느낌이 있었어요.

2) 같은 영상에 목소리만 따로 입히기
두 번째는 같은 영상에 보호자는 Eleven 음성 템플릿, 비숑은 템플릿 없이 Seed로 만든 목소리를 입혀봤습니다.
이번에는 보호자 목소리를 잘 들어보세요. 첫 대사부터 마지막 대사까지 같은 사람이 말하는 느낌이 훨씬 잘 살아나요.
대신 영상과 음성을 따로 만들었기 때문에 입을 여는 순간과 대사가 시작되는 타이밍은 제가 직접 맞춰야 했습니다.
그리고 비숑은요… 분명 매번 ‘5살 여자아이 목소리’라고 했거든요? 그런데 신나게 말해달라거나 속도를 조금 바꾸면 갑자기 다른 아이가 나와요. 한 번에 6크레딧이라 가볍게 시작했다가 비숑 목소리에서 크레딧을 꽤 썼습니다.
역시 템플릿이 있는 것이 효율성과 정신 건강에 좋은 것 같습니다..^^

저는 “아까는 ‘산’만 말해도 알아듣더니?” 이 대사만큼은 두 번째 영상에 한 표예요. 마지막 “알아듣더니?” 하는 말투가 비숑을 살짝 놀리는 장면에 딱 맞았거든요.
다음에 여러 컷으로 영상을 만든다면 비숑도 보호자처럼 음성 템플릿을 먼저 골라보려고요. 신나게 말할 때도, 목욕 가기 싫어서 투덜거릴 때도 같은 비숑 목소리로 들리면 좋겠어요.
여러분은 두 영상 중 어느 쪽 대화가 더 자연스럽게 들리셨나요?